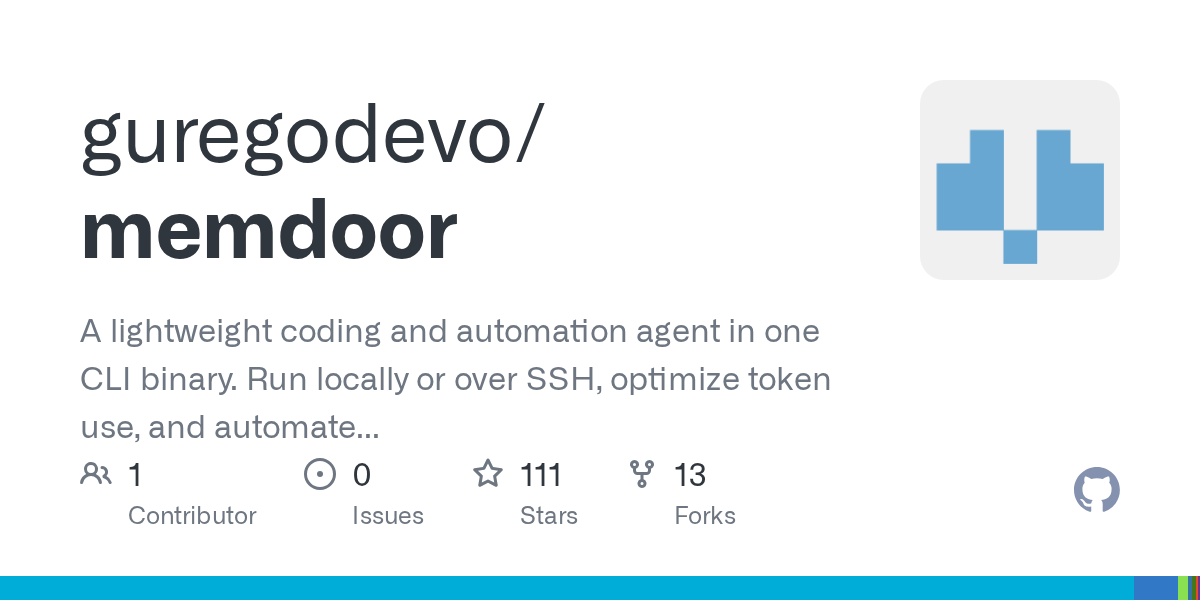
Une nouvelle entrée sur GitHub affirme qu'une équipe de cinq modèles Qwen3.8-27B bat Fable 5 sur LiveCodeBench Hard, un benchmark exigeant pour le code assisté par IA. Le résultat apparaît dans le dépôt Memdoor du développeur guregodevo, qui se présente comme un agent léger de code et d'automatisation intégré dans un seul binaire en ligne de commande.
L'enjeu est simple : LiveCodeBench Hard sert à tester la génération de code sur des problèmes difficiles. Qu'une configuration multi-modèles Qwen3.8-27B dépasse Fable 5 suggère donc que les modèles à poids ouverts peuvent rivaliser au sommet des benchmarks de code lorsqu'ils sont réunis en équipe. Le dépôt ne fournit toutefois pas d'article technique complet : ce résultat doit être considéré comme une affirmation du projet, et non comme une étude vérifiée de façon indépendante.
Ce que dit le résultat team-solve de Memdoor
D'après le dépôt Memdoor, le flux de travail team-solve figure dans examples/workflows/team-solve, avec des dossiers bench, sample et steps. Le projet inclut donc un dispositif de benchmark destiné à comparer l'approche en équipe sur des tâches de code.
Le README complet de ce flux n'est pas reproduit dans le texte source : les détails comme les scores exacts, les versions des modèles et les conditions d'exécution ne sont pas confirmés ici. Aucun score précis, aucune date et aucune configuration ne sont donnés dans la source disponible. Les lecteurs sont invités à consulter directement le dépôt pour obtenir les chiffres exacts.
- Résultat annoncé : cinq modèles Qwen3.8-27B en équipe battent Fable 5 sur LiveCodeBench Hard.
- Source : dépôt GitHub guregodevo/memdoor.