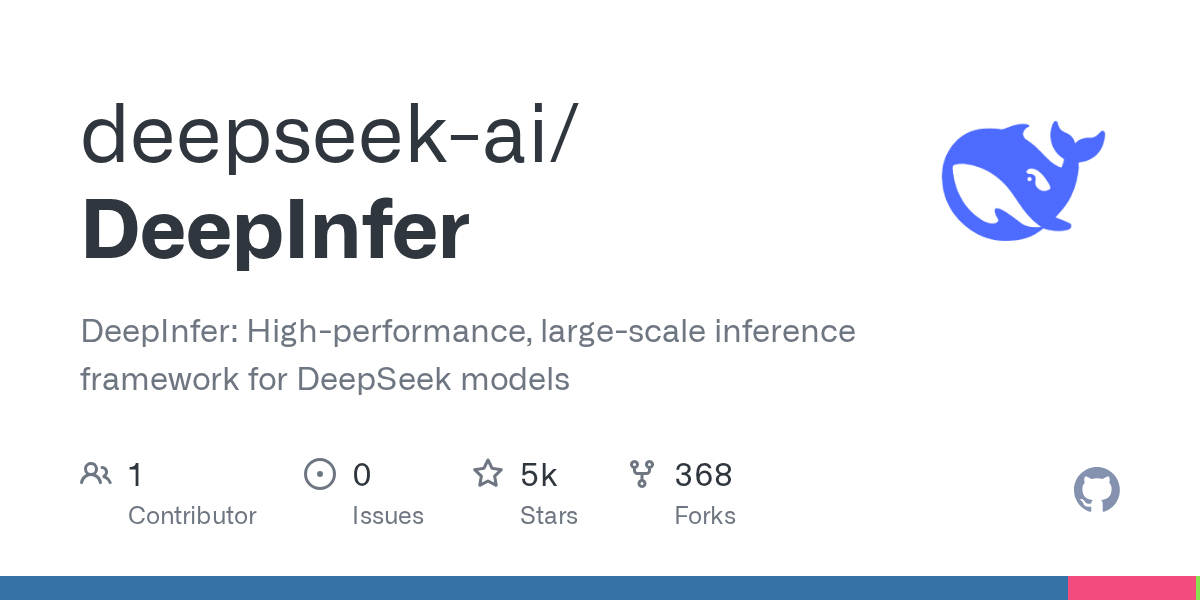
DeepSeek a mis en open source DeepInfer, un cadre d'inférence haute performance conçu pour servir ses grands modèles linguistiques à grande échelle. Le code est désormais disponible sur GitHub au sein de l'organisation deepseek-ai de l'entreprise, offrant aux développeurs externes un accès direct aux logiciels que DeepSeek utilise pour faire tourner ses modèles.
L'inférence est l'étape où un modèle entraîné répond à une requête — la partie que les utilisateurs ressentent réellement, en latence comme en coût. En publiant DeepInfer plutôt qu'en le gardant en interne, DeepSeek confie à la communauté IA une partie de sa pile de production, dans la droite ligne de la stratégie d'open weights qui a fait de l'entreprise un acteur incontournable des débats mondiaux sur l'IA.
Ce qu'est réellement DeepInfer
Le dépôt GitHub décrit DeepInfer comme un cadre d'inférence haute performance à grande échelle pour les modèles DeepSeek. L'arborescence du projet comprend des répertoires distincts pour le code source en C, le clustering, le paquet principal deepinfer, la documentation, les outils d'évaluation, des exemples et des scripts — la structure d'un cadre conçu pour être déployé, pas seulement lu.
Le dépôt affiche également 15 pull requests ouvertes, signe d'un développement actif et continu plutôt que d'un simple dépôt de code ponctuel. Ce rythme compte : les moteurs d'inférence vivent ou meurent au gré des réglages constants pour le nouveau matériel et les nouvelles versions de modèles.
Pourquoi l'open source de la couche de serving compte
Les poids des modèles font les gros titres, mais c'est le moteur d'inférence qui détermine à quel prix et à quelle vitesse ces poids peuvent répondre au trafic réel. Libérer cette couche permet aux fournisseurs de cloud, aux startups et aux chercheurs d'optimiser les modèles DeepSeek sur leur propre matériel au lieu de dépendre de l'API de DeepSeek.