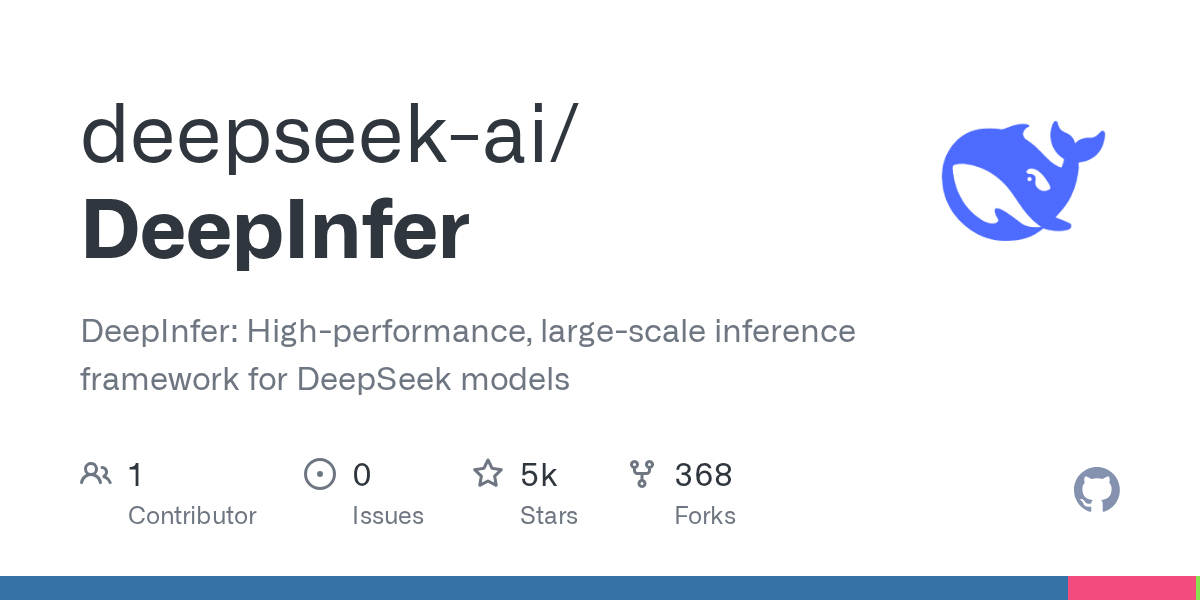
أعلنت شركة DeepSeek عن فتح مصدر DeepInfer، وهو إطار استدلال عالي الأداء مصمم لتشغيل نماذجها اللغوية الضخمة على نطاق واسع. وقد أتاح الفريق الكود على GitHub ضمن منظمة deepseek-ai، مما يمنح المطورين الخارجيين وصولاً مباشراً إلى البرمجيات التي تستخدمها الشركة لتشغيل نماذجها.
الاستدلال هو المرحلة التي يجيب فيها النموذج المدرَّب عن طلب ما، وهو الجزء الذي يلمسه المستخدم فعلياً من حيث زمن الاستجابة والتكلفة. وبطرح DeepInfer للعموم بدلاً من إبقائه داخلياً، تضع DeepSeek بين يدي مجتمع الذكاء الاصطناعي جزءاً من حزمة الإنتاج الخاصة بها، تماشياً مع استراتيجية الأوزان المفتوحة التي جعلت الشركة محطّ أنظار في النقاشات العالمية حول الذكاء الاصطناعي.
ما هو DeepInfer فعلياً؟
يصف مستودع GitHub إطار DeepInfer بأنه إطار استدلال عالي الأداء وواسع النطاق لنماذج DeepSeek. ويضم هيكل المشروع مجلدات منفصلة لكود المصدر بلغة C، وللتجميع العنقودي (clustering)، ولحزمة deepinfer الأساسية، وللتوثيق، وأدوات التقييم، والأمثلة، والسكريبتات — وهو شكل إطار مخصص للنشر والتشغيل وليس للقراءة فقط.
كما يُظهر المستودع 15 طلب سحب (pull request) مفتوحاً، ما يشير إلى تطوير نشط ومستمر بدلاً من إيداع كود لمرة واحدة. وهذه الوتيرة مهمة: فمحركات الاستدلال تعيش أو تموت على الضبط المستمر للعتاد الجديد وإصدارات النماذج الجديدة.
لماذا يهم فتح مصدر طبقة التشغيل؟
تحظى أوزان النماذج بالعناوين الرئيسية، لكن محرك الاستدلال هو الذي يحدد مدى رخص وسرعة استجابة هذه الأوزان لحركة المرور الفعلية. وإتاحة هذه الطبقة تسمح لمزودي الخدمات السحابية والشركات الناشئة والباحثين بتحسين نماذج DeepSeek على عتادهم الخاص بدلاً من الاعتماد على واجهة برمجة تطبيقات DeepSeek وحدها.
كما يزيد ذلك الضغط على المنافسين. فإذا كانت حزمة التشغيل لدى DeepSeek متاحة مجاناً للفحص والتحسين، فإن المحركات المغلقة المنافسة ستضطر إلى تبرير فجوة أدائها بصوت أعلى — وهو ديناميكي ظهر بالفعل حول نماذج DeepSeek نفسها.