Cerebras a publié une explication détaillée de la façon dont elle déploie des modèles d'IA à 1000 milliards de paramètres sur son matériel à l'échelle du wafer, en prenant comme exemple le modèle open source Kimi K3. Dans un article daté du 22 octobre 2026, l'entreprise indique qu'elle répartit un grand modèle de frontière sur plusieurs wafers WSE-3T afin de servir des modèles de plusieurs milliers de milliards de paramètres à 1000–2000+ jetons par seconde.
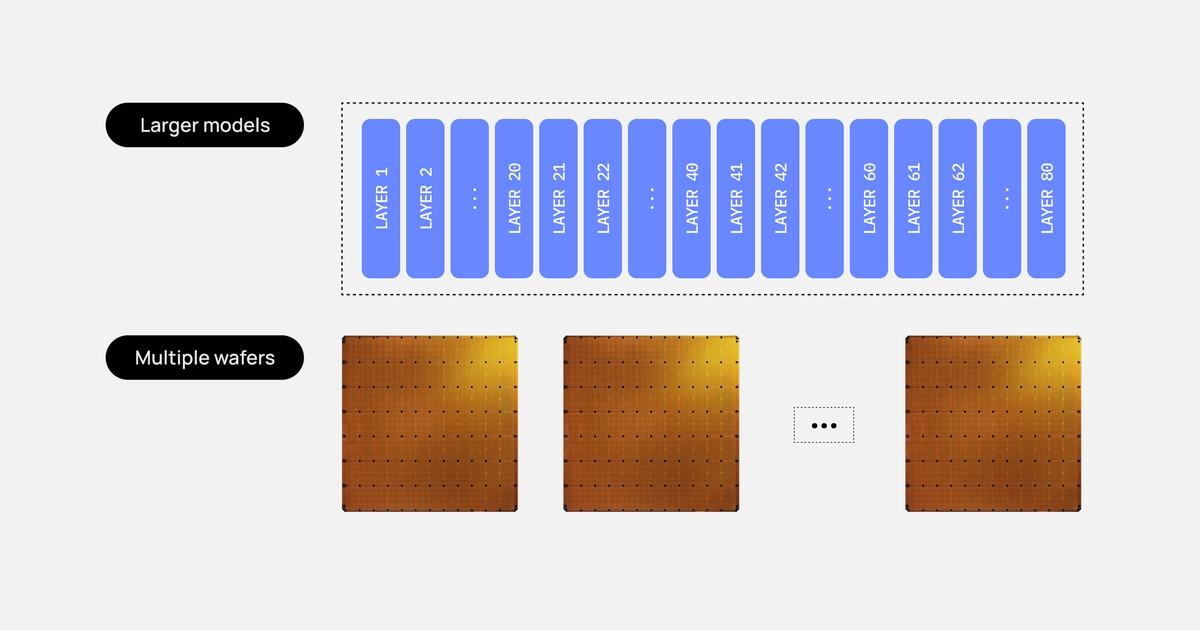
Le défi technique, c'est la mémoire : un wafer WSE-3T dispose de 44 Go de mémoire embarquée, alors que les modèles à 1000 milliards de paramètres nécessitent des téraoctets rien que pour leurs poids. La réponse de Cerebras consiste à répartir le modèle couche par couche sur des dizaines de wafers et à les relier en pipeline.
Comment Cerebras répartit Kimi K3 sur 59 wafers
Kimi K3 est un modèle open source d'environ 3000 milliards de paramètres, composé de 69 couches d'attention linéaire et de 24 couches denses. Stockés sur 4 bits chacun, les paramètres bruts représentent environ 1,5 To répartis sur 93 couches, soit environ 16 Go par couche, selon Cerebras.
Comme chaque wafer dispose de 44 Go de SRAM embarquée et qu'une couche ne nécessite qu'environ 16 Go, la plupart des couches tiennent entièrement sur une seule puce. Cerebras en déduit que les poids du modèle ne bougent généralement jamais et que les couches n'ont pas besoin d'être scindées entre les wafers : seules les activations circulent entre elles.
La répartition de ces couches sur les wafers donne 35 wafers pour les couches d'attention linéaire et 24 pour les couches denses, soit un total de 59 wafers. Le runtime achemine ensuite les jetons entre les wafers, en faisant transiter les activations via RDMA over Ethernet à environ 2 microsecondes par saut.
- Kimi K3 : environ 3000 milliards de paramètres, 69 couches d'attention linéaire et 24 couches denses