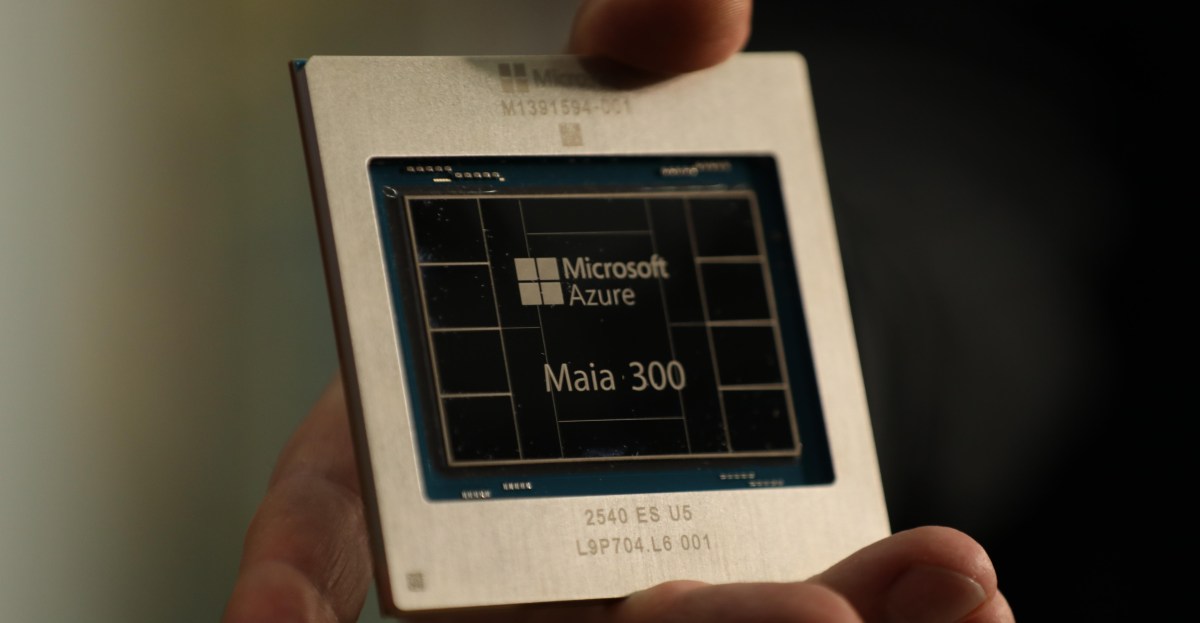
Microsoft a annoncé la Maia 300, sa puce d'intelligence artificielle de troisième génération développée en interne, qu'elle présente comme le futur « système principal d'inférence IA » de ses produits et services. Selon l'entreprise, ce nouveau silicium est conçu pour les modèles de raisonnement et les charges de travail agentiques qui dominent désormais le trafic IA dans le cloud.
La puce marque un virage stratégique clair : Microsoft veut exécuter la majorité de son inférence IA sur du matériel qu'elle conçoit elle-même, plutôt que sur des GPU de Nvidia et d'AMD. La Maia 300 commencera à être déployée sur des charges de travail IA en production en 2027, selon Microsoft, avec des déploiements Azure de plusieurs gigawatts prévus à partir de cette année-là.
Fiche technique de la Maia 300 et gains d'efficacité
Microsoft mise gros sur l'efficacité, la mesure qui compte le plus lorsque les coûts d'inférence IA se calculent en mégawatts. L'entreprise annonce un gain majeur par rapport aux systèmes reposant sur des GPU, et une progression encore plus importante par rapport à sa propre génération précédente en configuration de baies denses.
La Maia 300 repose sur une architecture à chiplets gravée sur le nœud N2P de TSMC, séparant les fonctions de calcul, de contrôleur mémoire et d'entrées/sorties afin que chaque partie utilise la technologie la plus adaptée à son rôle. L'équipe matérielle Azure de Microsoft affirme que cela augmente la surface de silicium dédiée à la performance de calcul.
- 40 % de tokens par mégawatt en plus par rapport aux principaux systèmes à base de GPU, selon Microsoft
- Jusqu'à 7x le débit de tokens à l'échelle d'une baie par rapport à la Maia 200 dans une configuration complète de 96 accélérateurs