لم يعش الذكاء الاصطناعي الصوتي بعد لحظة ChatGPT، بحسب مسؤولين يعملون في قلب هذا القطاع. ورغم مليارات الدولارات التي تتدفق إلى الشركات الناشئة في مجال الصوت وسلسلة متواصلة من النماذج الجديدة التي تزعم أنها تبدو بشرية، لا تزال هذه التقنية تتعثر بطرق يلاحظها المستخدمون فوراً.
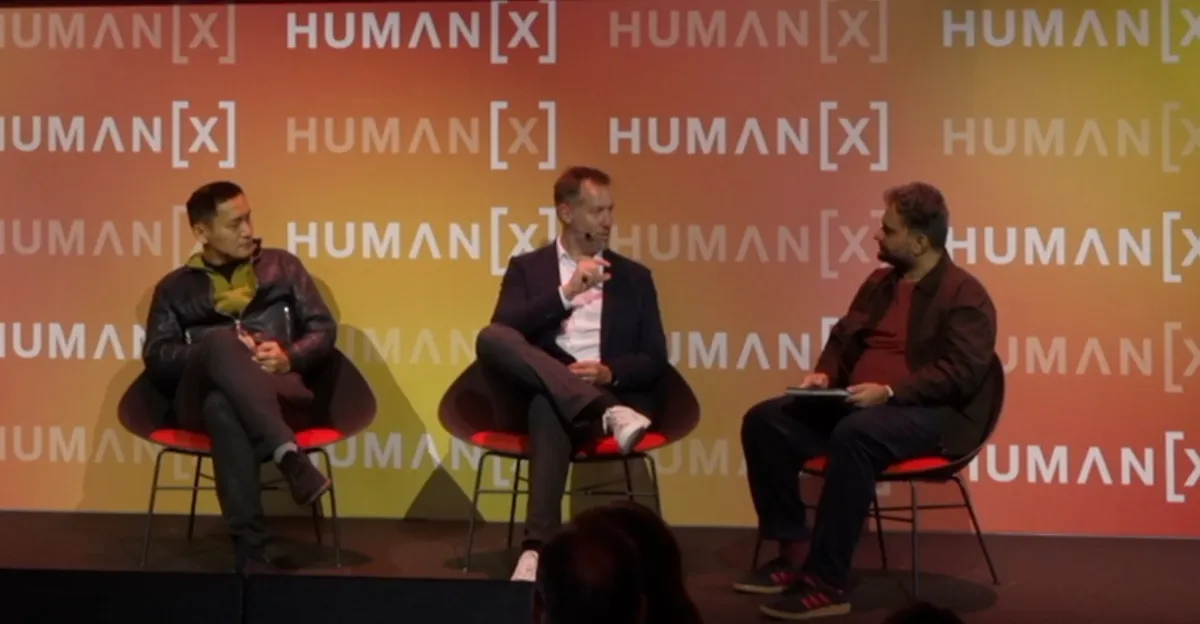
وخلال مؤتمر HumanX، رأى Shawn Wen المدير التقني في PolyAI وAlex Gay مدير التسويق في Otter أن القطع الناقصة هي التفكير السريع والسياق الموثوق والنسخ الدقيق. ويقولان إنه ما لم تتحسن هذه العناصر، سيواصل الوكلاء الصوتيون خسارة ثقة الأشخاص الذين يفترض أن يساعدوهم.
النماذج ثنائية الاتجاه الكامل مجرد خطوة أولى
أقرّ Wen بأن القطاع بلغ بالفعل مرحلة النماذج ثنائية الاتجاه الكامل، القادرة على الاستماع والتحدث في الوقت نفسه. لكنه يرى أن التحدي التالي يتمثل في جعل التفكير سريعاً بما يكفي لتصل الأجوبة بسرعة ويبدو الحوار طبيعياً.
وأضاف أن وكلاء خدمة العملاء يجب أن يتجنبوا النبرة الآلية وأن يمنحوا المتصلين الثقة بأن مشكلتهم ستُحل فعلاً. وبمجرد أن يتفاعل المتصل خلال أول دورين أو ثلاثة، تبدأ هذه الثقة بالتراكم، وقد لا يشعر بعدها بالحاجة إلى طلب التحدث مع إنسان.
لماذا تتعطل مسارات الذكاء الاصطناعي الصوتي
قال Gay إن Otter تتعامل مع النسخ كطبقة انطلاق وليس كهدف نهائي، لأن كل ما يليه يعتمد عليه. فإذا كان النص الأصلي غير دقيق، يصبح كل ملخص وكل إجراء لاحق مبني عليه معيباً، ويفقد المستخدمون ثقتهم بالمنصة بسرعة.
وأشار Wen إلى أن التعرف الآلي على الكلام يمثل نقطة ضعف متكررة، موضحاً أن نماذج ASR كثيراً ما تخطئ في كلمات مفتاحية مهمة وبالتالي تفشل في التقاط السياق الكامل. واتفق Gay على أن اللغة لا تزال مجالاً يحتاج فيه الذكاء الاصطناعي الصوتي إلى تحسينات كبيرة.
وتعمل Otter أيضاً على توائم رقمية يمكنها تمثيل الأشخاص في الاجتماعات. وقال Gay إن مثل هذا الصورة الرمزية يجب أن تحاكي التعبيرات العاطفية للحوار مع إنسان، وإلا فالتجربة مجرد روبوت أسئلة وأجوبة لا علاقة حقيقية.
وتشكل الشفافية هاجساً إضافياً. ويرى المسؤولان أن الأدوات ينبغي أن توضح متى يُسجَّل الحوار أو متى يكون الطرف الآخر ذكاءً اصطناعياً، وتستكشف Otter طرقاً لإخطار جميع المشاركين في الاجتماع حتى عندما لا يكون روبوتها حاضراً.