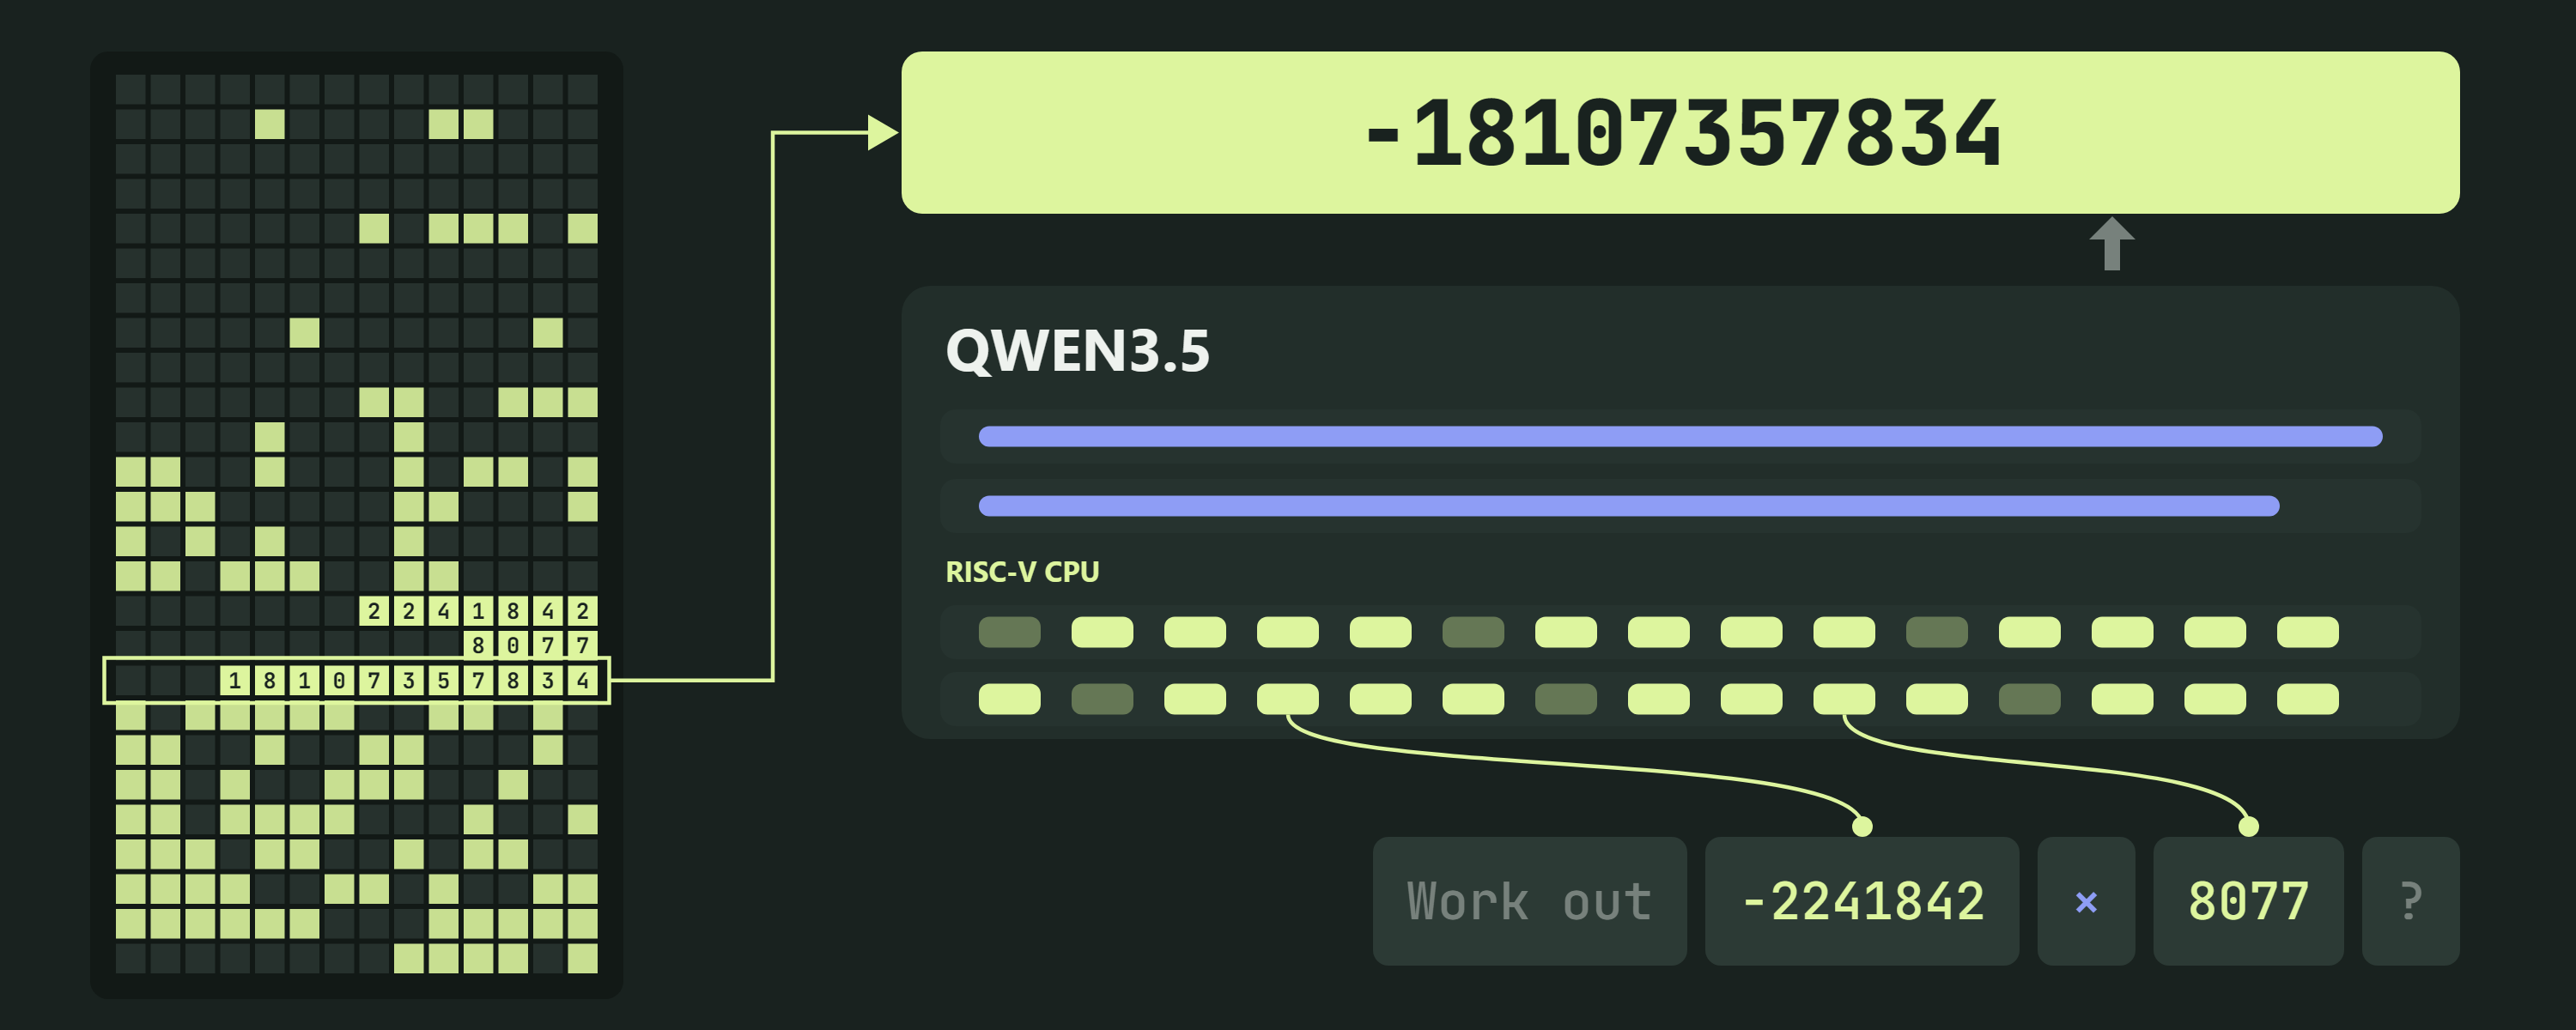
طوّر أحد المبرمجين مشروعًا تجريبيًا يُدعى Qwenputer، وهو نسخة معدّلة من نموذج Qwen 3.5 4B تحتوي على معالج RISC-V بنية 32 بت مُدمج مباشرة في أوزان النموذج. وبحسب ما ورد في تقرير المشروع المنشور على موقع divagr.com، فإن المعالج لا يعمل كإضافة أو أداة أو بيئة معزولة، بل ينفّذ تعليماته داخل عمليات الاستدلال الأمامية للنموذج نفسه، مستعينًا بطبقات الانتباه Gated DeltaNet الخاصة بـ Qwen كذاكرة وصول عشوائي.
يُعدّ المشروع عرضًا لافتًا لمدى إمكانية الضغط على البنية الداخلية للنماذج دون تدريب إضافي. فنواة RISC-V تشغّل أكواد C و MicroPython، وتجتاز اختبارات riscv-tests الرسمية، وتطابق نتائجها نتائج qemu في جميع برامجها. ويذكر المطوّر أنه تمكن من تشغيل 18 مليون تعليمة بشكل حر دون أخطاء، أي أن المعالج يواصل العمل بناءً على مخرجاته الخاصة دون وجود آلة مرجعية تصحّح له بين الخطوات.
كيف يستخدم Qwenputer طبقات Gated DeltaNet كذاكرة RAM
يعتمد Qwen3-Next و Qwen 3.5، وهما النموذجان اللذان بُني عليهما Qwenputer، على آلية Gated DeltaNet (GDN) في ثلاث من أصل أربع طبقات انتباه. وتحتفظ كل رأس من رؤوس GDN بمصفوفة حالة، وتحدد قيمة البوابة بين 0 و1 مقدار تلاشي تلك الحالة مع كل رمز. واكتشف المطوّر أنه بضبط البوابة على 1 وقوة الكتابة (beta) على 1 واستخدام ترميز مفتاح أحادي، تصبح كل عملية كتابة تستبدل صفًا واحدًا بالضبط، وكل استعلام قادر على استرجاع قيمة دقيقة.
هذا يجعل طبقات GDN تعمل كذاكرة وصول عشوائي دقيقة وقابلة للعنونة بتكلفة أقل بكثير من استخدام الانتباه العادي كذاكرة، لأن حجم حالة رأس GDN يبقى ثابتًا مهما طال الحوار. ويُنسب التقرير إلى Schlag وIrie وSchmidhuber (2021) الفضل في إظهار أن الانتباه الخطي بقاعدة دلتا يعمل كذاكرة ترابطية، والخطوة الجديدة هنا تكمن في جعله دقيقًا وقابلًا للعنونة داخل نموذج إنتاجي، وبموثوقية تكفي لتشغيل معالج كامل عليه.
مواصفات معالج Qwenputer RISC-V ودقته
لم يُدرَّب المعالج بل جرى تجميعه: إذ يضبط المترجم كل وزن مباشرة عبر تحويل خطوات الدائرة إلى مكوّنات محوّل، برؤوس انتباه تبحث عن القيم ووحدات تغذية أمامية تنفّذ العمليات الحسابية ورؤوس DeltaNet تحتفظ بالذاكرة. وتتحول كل تعليمة إلى بضعة رموز مُولَّدة، وهذه الرموز هي أثر تنفيذ المعالج، فيعمل المعالج بينما يولّد Qwen تلك الرموز.